光電融合への全面移行の前に着脱式モジュールが再び脚光を浴びる理由
AIモデルの巨大化と推論需要の拡大が続く中、データセンターの拡張を制約する要因は演算半導体そのものから「計算機同士をつなぐ通信網と電力」へと広がっています。どれだけ高性能な演算装置を大量に並べても、それらを相互に結ぶネットワークの帯域や消費電力が上限に達すれば、施設全体の処理能力は頭打ちになるためです。
こうした課題に対し、米NVIDIAと米Ciscoは2026年10月12日(米国時間)、次世代のAIファクトリーに向けた新たな高密度光モジュールのフォームファクター「Ultra-Dense Small Form Factor Pluggable(USFP)」の計画を発表しました。従来のモジュールと同じ設置面積を維持しながら、4倍の帯域幅密度と約1.3倍の電力効率を実現する設計となっています。
今回は、この新規格がデータセンターの投資効率や運用実務にどのような変化をもたらすのか、背景にある技術的工夫とエコシステム形成の狙いについて、取り上げていきたいと思います。
帯域幅密度4倍と12.8Tb/秒を実現する新規格USFPの全容
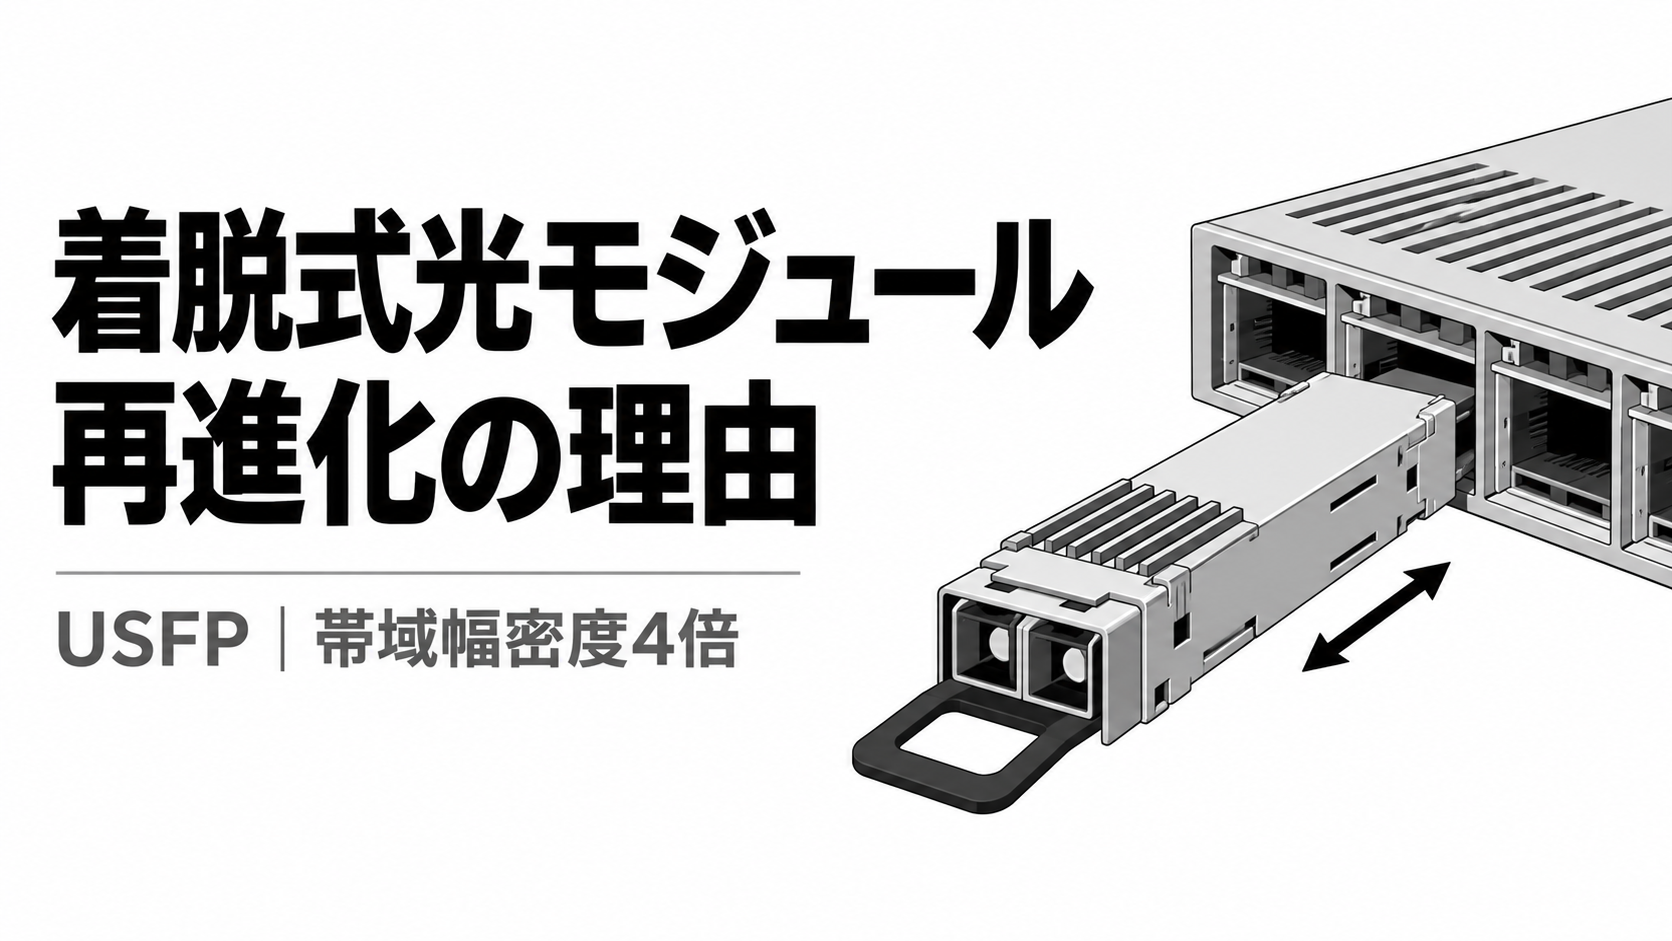
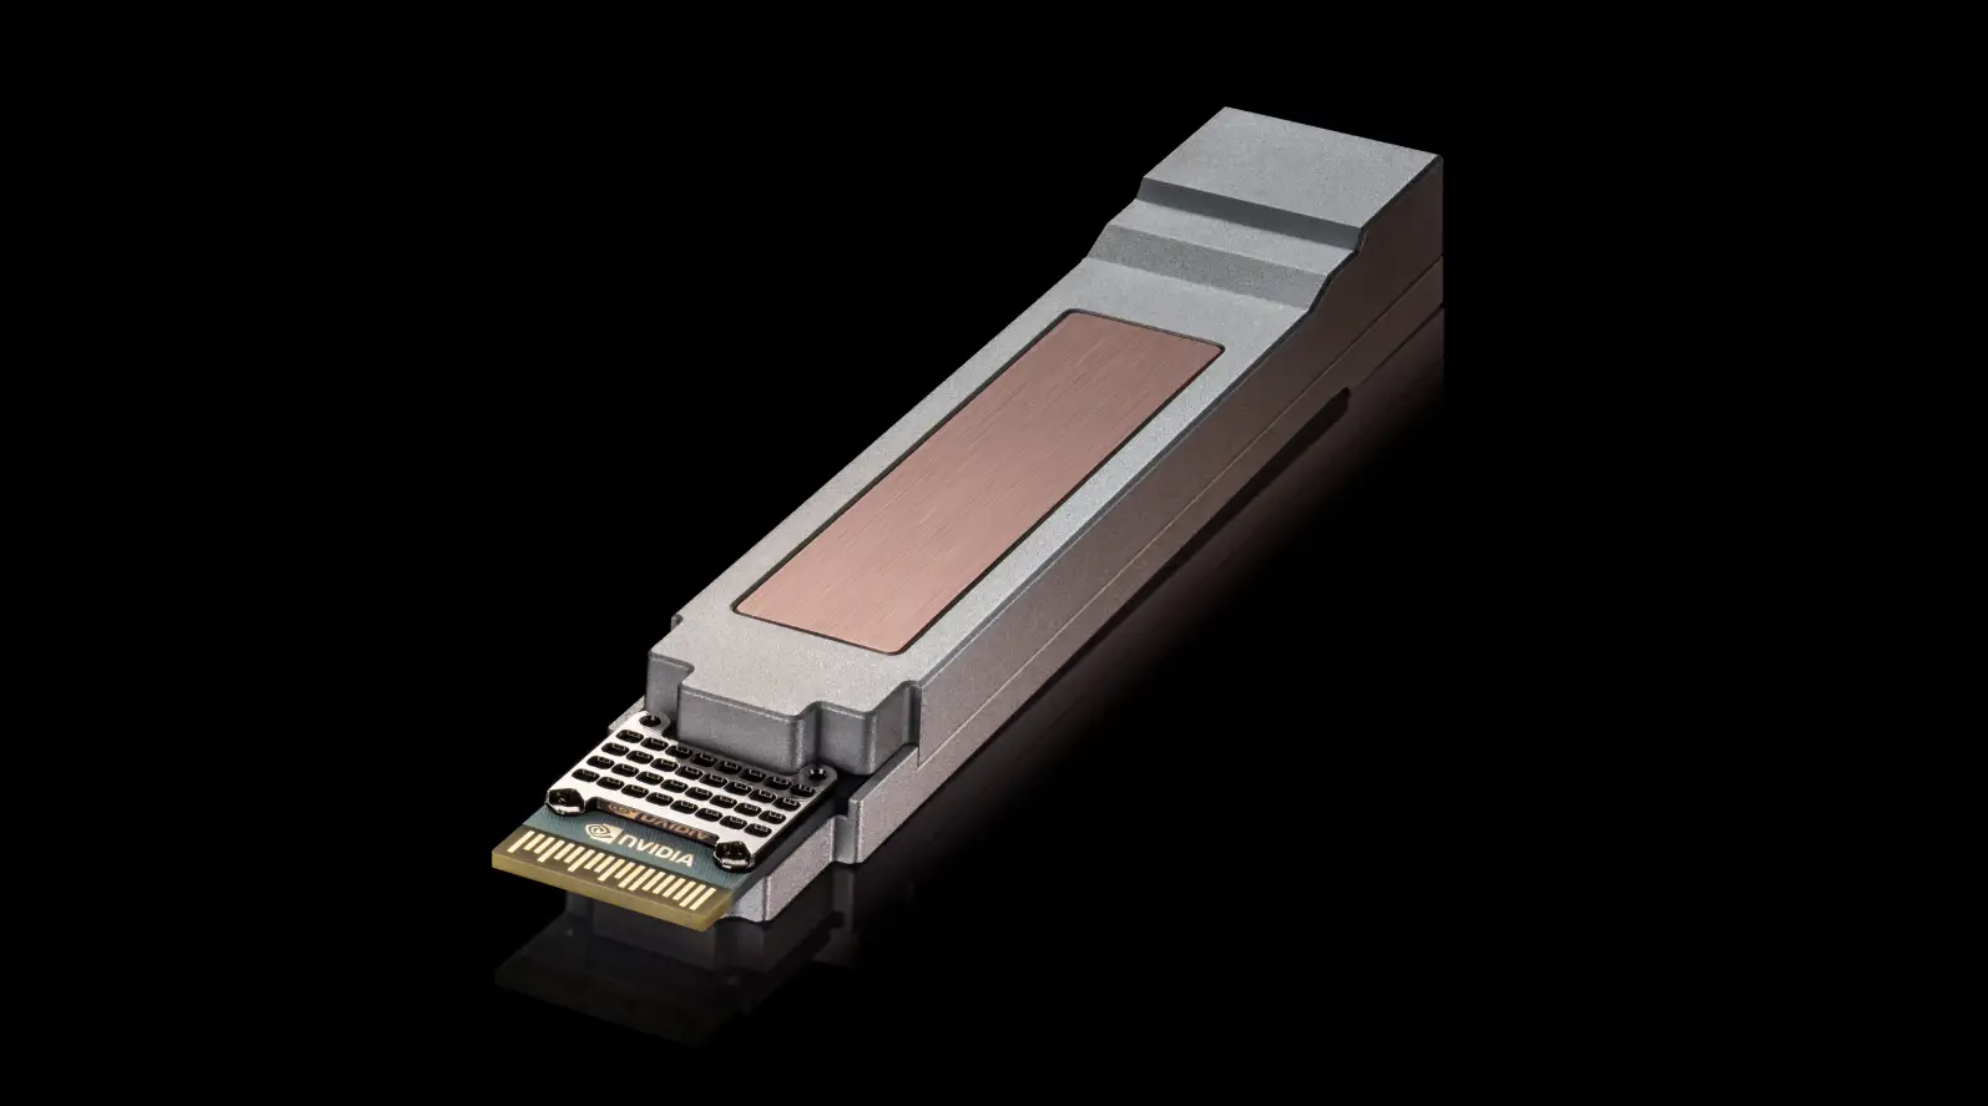
2026年10月12日に米国カリフォルニア州サンタクララのOCP(Open Compute Project)で発表されたUSFPは、1レーンあたり400Gb/秒の電気信号をサポートする初のモジュールとして設計されています。初期に計画されているトランシーバーは、データセンターで広く普及しているOSFP(Octal Small Form Factor Pluggable)と同じ設置面積に16の全二重レーンを搭載し、スイッチとSuperNICの双方に対応して最大12.8Tb/秒の容量を実現します。
従来の1レーンあたり200Gb/秒の光モジュールと比較すると、1レーンあたりの帯域幅と搭載レーン数がそれぞれ2倍となることで、フロントパネルの帯域幅密度は4倍に高まります。あわせて電力効率も約1.3倍に向上しており、将来的には32の全二重レーン以上へ拡張できる設計上の余地も確保されています。
出典:NVIDIA 2026.10
スイッチ階層の追加を防ぎ電力枠を計算資源へ配分する経済合理性
両社が光モジュールの高密度化を進める背景には、AIファクトリーの規模拡大に伴うネットワーク構造と電力予算の課題があります。インフラ拡張時には接続あたりの帯域幅とスイッチ1台あたりの接続数を同時に増やす必要がありますが、スイッチの容量が上限に達すると、階層や光リンクの追加が必要となり、遅延や消費電力、コストが増加する構造にあります。
USFPの採用により、インフラ構築者はネットワークの階層を追加することなく、より多くの1.6Tb/秒エンドポイントをイーサネットのAIファブリックへ接続できるようになると考えられます。同じ設置面積で収容能力を引き上げ、データ1ビットの転送電力を削減できれば、施設全体の電力予算に占めるネットワークの割合を抑えられます。限られた電力枠を本来の主役である演算システムへ優先配分できる点が、運用事業者にとって大きなメリットと想定されます。
保守性に優れる着脱式の維持と100ワット放熱・新型コネクタの工夫
現場運用の観点から注目されるのは、USFPが「プラガブル(着脱式)」の形態を継承している点です。1レーンあたり400Gb/秒の領域では信号減衰や発熱が増大し、既存設計の段階的な手直しでは対応が難しくなっていました。しかし、着脱できない一体型の実装方式へ急激に移行すれば、故障時の交換作業や保守手順が複雑化し、従来の運用モデルを継続できなくなる摩擦が生じます。
この課題を解消するため、USFPは新たな2次元アレイコネクタと2段階の挿入方式を採用しました。モジュール挿入後に高速信号用の接点が接続される構造により、接点の摩耗を減らして信号品質を高め、挿入力も予測しやすくしています。また、専用冷却回路を別途組み込まずに最大100ワットの放熱に対応し、信号処理を簡素化する光学設計で遅延と消費電力を抑えています。インフラを全面刷新せず、成熟した保守性と製造性を保ちながら次世代技術を導入できる仕組みと考えられます。
NVIDIAとCiscoの連合にコネクタ大手が加わるオープン標準化の力学
産業構造の面では、今回の枠組みが特定企業の独自規格ではなく、幅広いエコシステムの形成を前提としている点が重要です。NVIDIAの「Spectrum-X」とCiscoの「Silicon One」によるイーサネット連携を基盤としつつ、ケージやコネクタ、モジュールの開発には当初からTE ConnectivityとAmphenolが参画しています。物理層を担う世界的なコネクタ大手2社が初期から関与することで、量産性と供給体制を早期に固める狙いが読み取れます。
大規模なインフラ構築者にとって単一サプライヤーへの依存は調達リスクにつながるため、両社は今後開始するコミュニティ主導のマルチソースプロジェクトを通じてオープンな業界仕様を策定する方針です。複数の供給元からなるエコシステムを整えることで、企業やネオクラウド、ソブリンクラウドにおけるAIインフラ導入を簡素化する効果が予想されます。
注視すべき仕様策定の進捗と32レーン拡張へのロードマップ
今後の動向を見極める上では、3つの観測点が挙げられます。第1に、マルチソースプロジェクトにおけるオープン仕様の策定時期と、コネクタ大手2社に続く新規パートナーの参画規模です。サプライヤーの広がりが、実調達におけるコスト競争力を測る基準となります。
第2に、1レーンあたり200Gb/秒の環境における先行的な導入効果です。USFPのコネクタは400Gb/秒を見据えて設計されているため、既存の200Gb/秒環境でも性能向上が見込まれています。第3に、初期の16レーンから将来計画の32全二重レーン以上へと拡張する時期です。幅広い光技術と接続距離に対応する柔軟性が実運用でどう評価されるかが、次世代ネットワークの普及ペースを測る指標になると考えられます。
光インターコネクトの主導権争いと日本の部材・インフラ産業への波及
AIデータセンターの競争軸は、演算半導体の単体性能から、ネットワークや熱処理を含めた施設全体の電力効率へと広がっています。USFPのような高密度プラガブル規格がオープンな業界標準として定着すれば、運用事業者は既存の保守ノウハウを生かしたまま段階的な拡張を進めやすくなると予想されます。
この動きは、日本国内で整備が進むソブリンクラウドや企業のAI基盤にとっても、投資計画の予見性を高める要素となります。既存設備を全面的に作り直すことなく次世代の通信帯域を取り込めるため、長期的なインフラ投資の最適化を図りやすくなるためです。
また、1レーン400Gb/秒の高速伝送と100ワットの放熱を両立させるには、高精度な光学部品や低損失な基板材料、放熱部材が不可欠です。精密加工や高機能素材に強みを持つ日本の電子部品・素材メーカーにとっても、オープンな仕様策定の初期段階からエコシステムに参画し、次世代AIインフラのサプライチェーンで存在感を高める好機が広がっていくでしょう。